Un modèle local pour une forme de fraude en croissance
Google DeepMind et l’agence technologique du gouvernement de Singapour, GovTech Singapore, ont annoncé le 14 octobre avoir adapté un modèle Gemma pour détecter des conversations frauduleuses sur un téléphone. Le projet vise les fraudes par manipulation : faux emploi, placement douteux, usurpation d’une banque ou d’un organisme public, puis pression graduelle pour obtenir de l’argent ou des identifiants. Selon Google DeepMind, les fraudes représentent plus de la moitié des crimes signalés à Singapour et ont causé plus de 4 milliards de dollars singapouriens de pertes depuis 2019. L’entreprise affirme que les scénarios conversationnels peuvent maintenant compter pour jusqu’à 80 % des pertes. Ces nombres décrivent le contexte singapourien et proviennent de l’annonce du partenaire technologique; ils ne mesurent pas encore l’efficacité du nouveau modèle. Le projet a été présenté pendant la Singapore International Cyber Week, dans le cadre du partenariat national sur l’IA conclu entre Google et le gouvernement singapourien.
Deux filtres doivent analyser la conversation
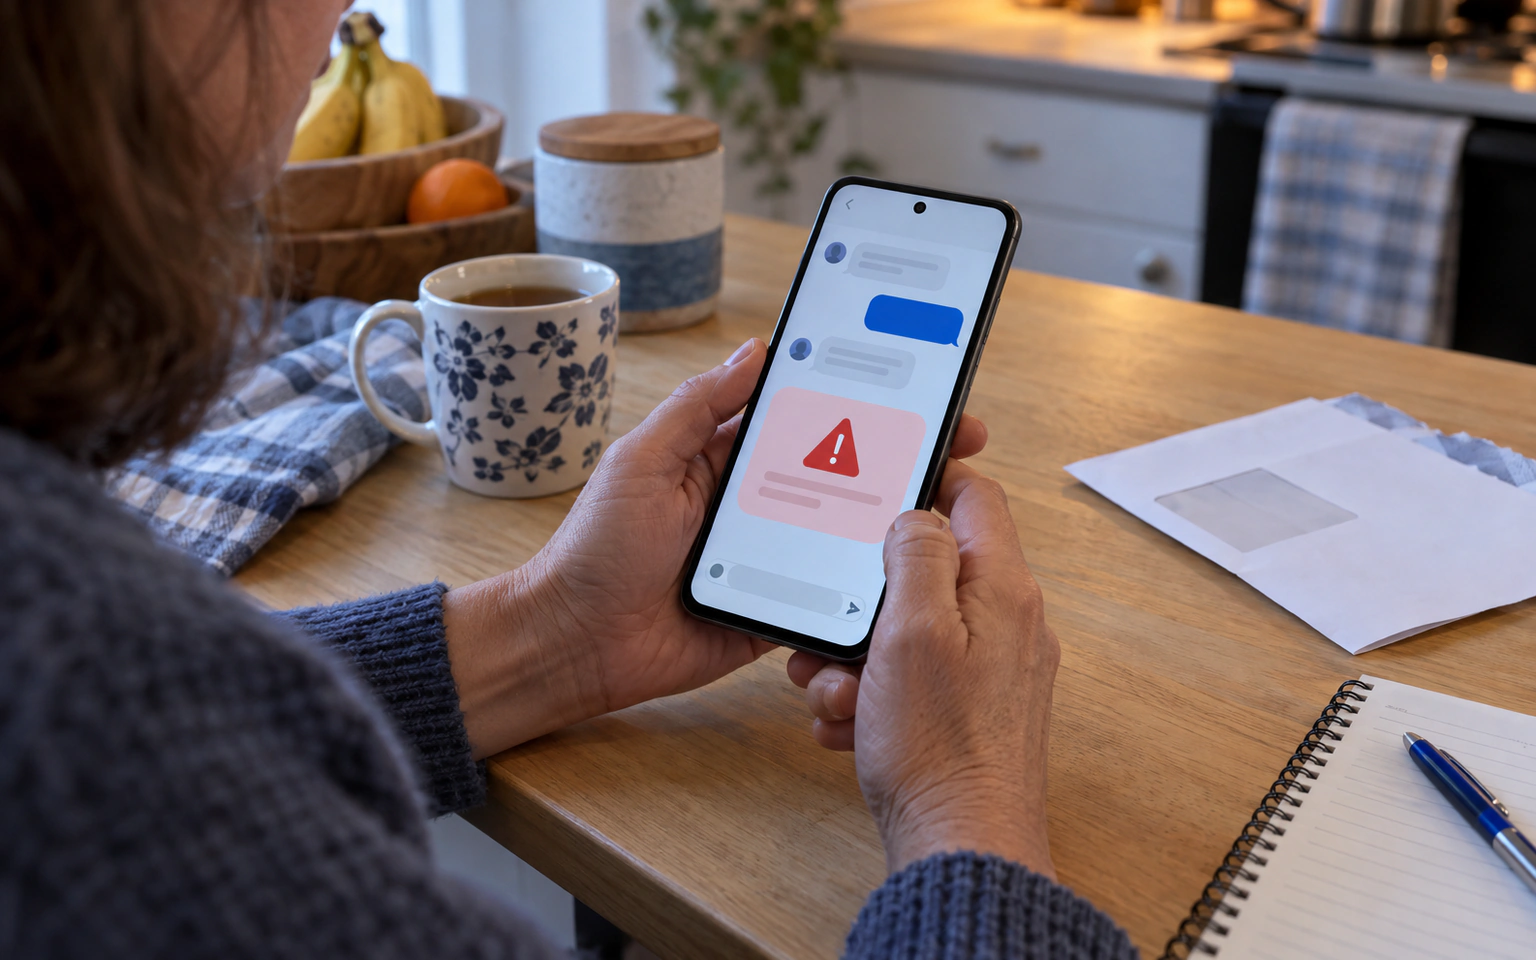
Le système repose sur deux étapes. Un premier classificateur léger examine les messages entrants en consommant peu d’énergie. Il doit laisser passer les échanges ordinaires et envoyer seulement les cas suspects vers une deuxième analyse. Le modèle Gemma adapté reçoit alors un extrait plus large de la conversation pour rechercher un enchaînement de manipulation. S’il confirme le risque, le téléphone affiche une alerte demandant à la personne de faire une pause avant de transmettre un renseignement ou d’envoyer de l’argent. Cette approche cherche à résoudre un problème que les filtres de mots-clés traitent mal. Une fraude peut commencer par une conversation banale, bâtir une relation de confiance, puis introduire une urgence plusieurs messages plus tard. Le contexte devient donc utile. Google affirme avoir entraîné le modèle sur des scénarios locaux, dont les imitations de banques, d’institutions publiques et de personnalités singapouriennes. Le système vise toutes les fraudes conversationnelles, et pas seulement celles dont les messages ont été produits par une IA.
Les messages doivent rester sur l’appareil
La caractéristique centrale est le traitement local. Les messages ne seraient pas envoyés vers un serveur de Google ou du gouvernement pour être analysés. Lorsqu’il sera intégré à une application, le modèle pourra consulter une conversation seulement avec le consentement de la personne et selon les conditions de cette application. Google dit que ni l’entreprise ni le gouvernement singapourien ne pourront accéder aux échanges par l’entremise du système. L’entraînement a aussi été isolé dans un environnement infonuagique géré par GovTech Singapore. L’annonce indique que les données privées et les renseignements permettant d’identifier des citoyens ont été exclus. Les jeux de données auraient été anonymisés à partir de signalements de fraude et de renseignements détenus par les autorités, puis complétés par des dialogues synthétiques pour les essais. Ces garanties décrivent l’architecture et les règles annoncées. Elles devront être confirmées dans les applications finales, car les permissions, les mises à jour et la collecte de données de diagnostic peuvent changer la confidentialité réelle d’un produit.
Aucun taux de réussite n’est encore publié
Le projet n’est pas présenté comme une fonction déjà disponible pour tous. Le déploiement doit se faire progressivement, en partenariat avec le gouvernement de Singapour. Google n’a donné ni date, ni liste d’appareils compatibles, ni nom d’application. Channel NewsAsia rapporte que le modèle est destiné aux appareils Android et que les instructions d’installation seront communiquées plus tard. Il manque aussi les mesures nécessaires pour juger la protection promise. Aucun taux de détection, taux de faux positifs, temps de réponse ou effet sur la batterie n’est publié. On ignore comment le système se comporte avec une langue mélangée, des messages vocaux, des images ou une conversation déplacée d’une application à une autre. Une alerte trop fréquente risque d’être ignorée; une alerte trop rare peut donner un faux sentiment de sécurité. L’annonce précise que le modèle a été soumis à des dialogues synthétiques et à des corpus locaux, mais elle ne fournit pas de protocole, de groupe de comparaison ni d’évaluation indépendante.
Une piste utile au Québec, avec des conditions
Pour le Québec, l’intérêt du projet tient moins à une application singapourienne qu’à son architecture. Un petit modèle local pourrait analyser un contexte sensible sans copier tous les messages vers le nuage. La même idée pourrait servir aux banques, aux télécoms ou aux services publics, à condition d’être adaptée au français québécois, aux fraudes locales et aux obligations de protection des renseignements. Un modèle entraîné sur les institutions et les expressions de Singapour ne peut pas être transposé tel quel. La conception de l’alerte comptera autant que le modèle. Elle devrait expliquer le signal observé, proposer une action concrète et permettre de joindre un organisme ou une personne de confiance. Elle ne devrait pas bloquer automatiquement une conversation légitime ni devenir une preuve qu’un correspondant est criminel. Il faudra aussi mesurer les erreurs selon l’âge, la langue et le type d’appareil. Google et GovTech ont montré une voie technique crédible pour concilier contexte et confidentialité. La prochaine preuve décisive sera un essai public chiffré, suivi d’un déploiement où les utilisateurs comprennent exactement ce qui est lu, ce qui reste local et ce que l’alerte peut réellement garantir.