Le modèle n’est qu’une partie du service
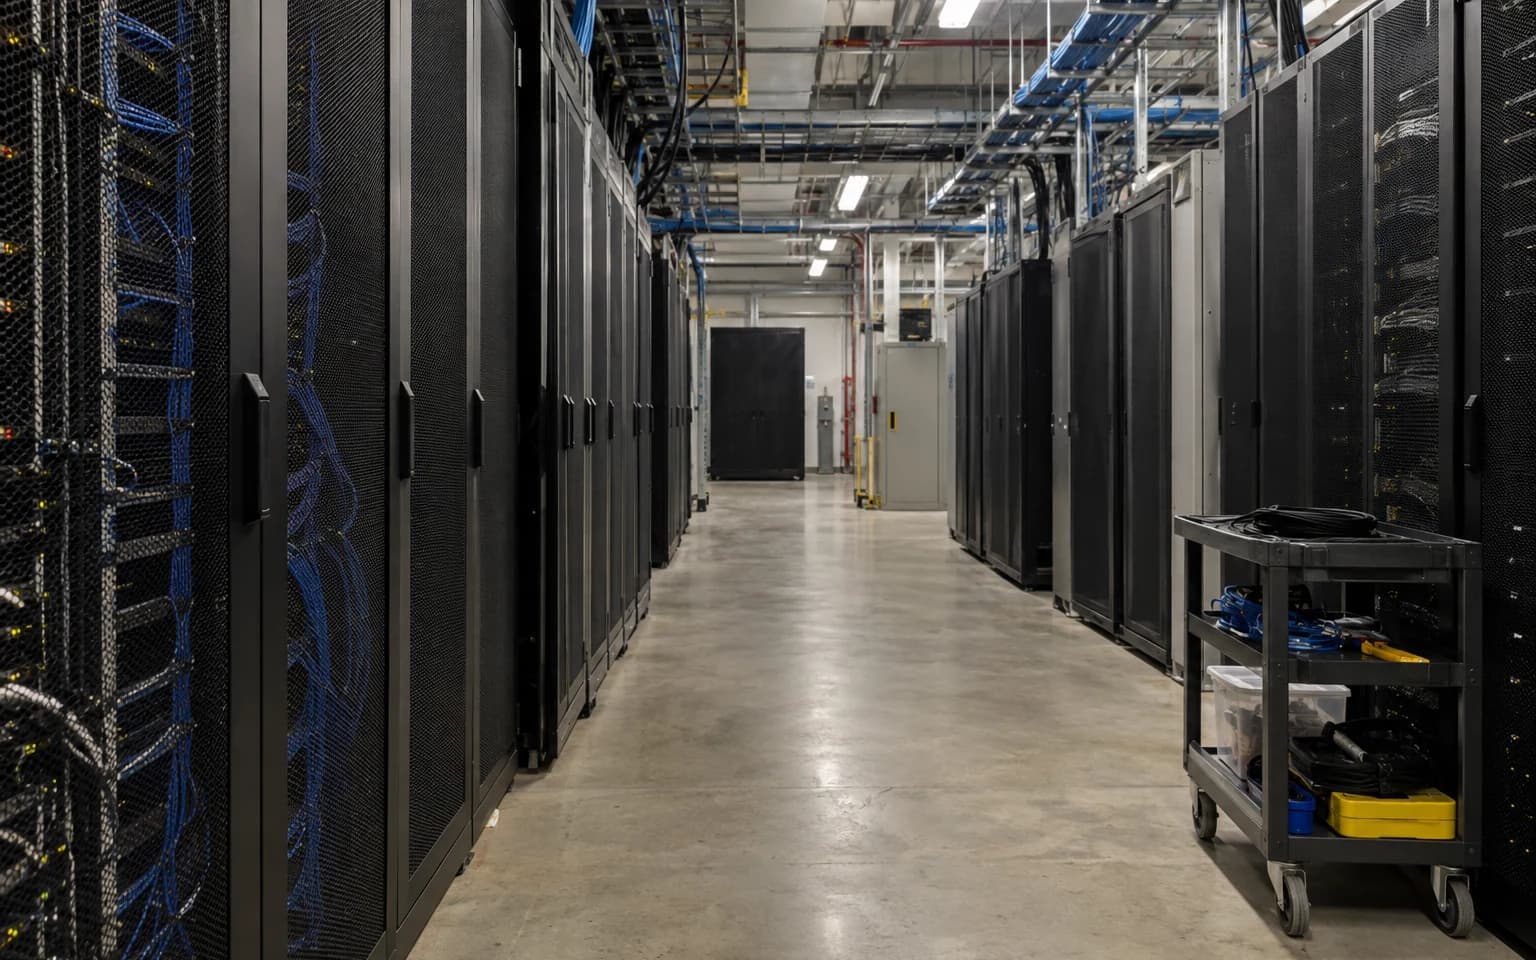
Quand un assistant répond vite, on attribue facilement toute l’expérience au modèle d’intelligence artificielle. Pourtant, une réponse utile dépend aussi de dizaines d’opérations moins visibles : retrouver un compte, charger une conversation, appliquer les permissions, lire des préférences et enregistrer le résultat. Dans un billet technique publié le 11 septembre, OpenAI décrit Habitat, sa plateforme de stockage en ligne. L’entreprise affirme que ce système traite plus de 70 millions de requêtes par seconde, sert des produits utilisés par plus d’un milliard de personnes chaque semaine et gère plus de 500 pétaoctets de données dans près de 40 régions. Ces chiffres viennent d’OpenAI et n’ont pas été vérifiés indépendamment par Le Journal IA. Ils illustrent néanmoins une réalité simple : même le meilleur modèle devient un mauvais produit si les données nécessaires arrivent en retard, avec les mauvaises permissions ou pas du tout.
La simplicité peut devenir une mesure de sécurité
OpenAI explique avoir volontairement limité les opérations offertes par Habitat. Au lieu de permettre à chaque équipe de lancer des requêtes complexes et imprévisibles, la plateforme privilégie des demandes simples dont le coût demeure plus facile à anticiper. Cette contrainte réduit la souplesse immédiate, mais elle limite aussi le risque qu’une seule opération trop lourde ralentisse tout le service. Pour une organisation plus petite, la leçon n’est pas de reproduire cette architecture. Elle consiste plutôt à encadrer ce qu’un outil d’IA peut demander. Un assistant qui consulte une liste approuvée de dossiers, avec une taille maximale et un délai d’exécution, sera souvent plus fiable qu’un système autorisé à fouiller librement plusieurs bases. Définir des limites claires peut paraître moins impressionnant dans une démonstration, mais rend le comportement plus prévisible lorsque l’usage devient quotidien.
Centraliser les règles facilite le contrôle, mais concentre le risque
Habitat a d’abord été une bibliothèque installée dans différents services. OpenAI raconte avoir ensuite déplacé cette logique vers un service central, notamment parce que les mises à jour coordonnées devenaient lentes et fragiles. Un point commun permet d’appliquer plus rapidement le routage, les contrôles d’accès, la journalisation et certaines règles de sécurité. Ce choix a toutefois une contrepartie : lorsqu’un composant central devient essentiel à plusieurs produits, sa panne ou une mauvaise configuration peut toucher davantage d’usages. Dans une PME, le même arbitrage apparaît lorsqu’on relie plusieurs processus à un seul assistant ou à une seule base de connaissances. Une gouvernance commune aide à maintenir les règles, mais elle exige des sauvegardes, une surveillance compréhensible et une façon de continuer le travail lorsque le système est indisponible. Centraliser ne supprime pas le risque; cela le rend plus visible et, idéalement, mieux gérable.
Une dette technique peut être raisonnable si elle a une date de sortie
OpenAI indique avoir conservé Python pendant une période de croissance, même si ce langage entraînait des coûts de calcul et des délais moins favorables pour ce service. L’équipe présente ce choix comme une dette technique assumée : stabiliser l’architecture d’abord, puis réécrire lorsque les besoins et les interfaces seraient mieux compris. Selon l’entreprise, deux ingénieurs aidés de Codex et de GPT-5.5 ont migré le service vers Rust au deuxième trimestre de 2026. OpenAI rapporte une efficacité six fois supérieure pour le processeur et quinze fois supérieure pour la mémoire. Ces résultats internes ne constituent pas une promesse applicable à d’autres projets. L’idée plus générale reste pertinente : choisir une solution assez bonne pour apprendre peut être rationnel, à condition de mesurer ses limites, de prévoir le moment où elle devra évoluer et de ne pas transformer le provisoire en dépendance oubliée.
Pour une petite équipe, commencer par les conditions d’échec
Avant de comparer les modèles, une équipe peut dresser la liste de ce qui doit rester vrai autour d’eux. Quelles données l’assistant peut-il lire? Que se passe-t-il si une source ne répond pas? Combien de temps attend-on avant d’abandonner une tâche? Qui voit les erreurs et qui peut relancer le processus? Il faut aussi distinguer les données nécessaires à une réponse immédiate des analyses plus lourdes qui peuvent attendre. OpenAI dit isoler certaines recherches complexes de son stockage transactionnel afin de protéger les opérations courantes. À une autre échelle, une entreprise peut appliquer le même principe en séparant un assistant utilisé devant un client d’un traitement expérimental lancé en arrière-plan. La qualité d’un projet d’IA ne se mesure donc pas seulement à la réponse obtenue pendant un essai réussi. Elle se voit dans la façon dont le système limite une mauvaise demande, explique un échec et permet au travail de reprendre sans perdre le fil.